
20 Tabellen, 0 Überblick
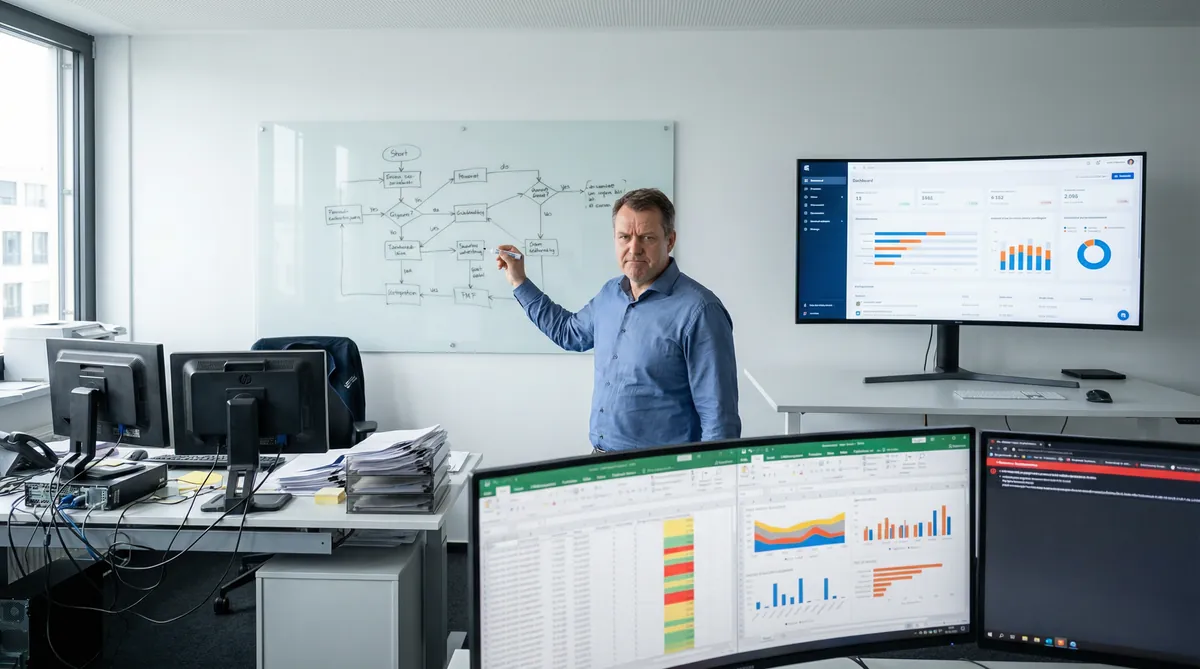
Du kennst das: Die Auftragsübersicht liegt in Excel, die Kundendaten im CRM, die Finanzdaten im ERP-System und die Projektzeiten in einem weiteren Tool. Wenn der Geschäftsführer fragt, wie rentabel Kunde X im letzten Quartal war, beginnt das große Zusammensuchen. Jemand exportiert Daten aus vier Systemen, kopiert alles in eine neue Tabelle, rechnet manuell zusammen – und zwei Stunden später hat man eine Antwort, die vielleicht stimmt.
Das ist kein Ausnahmefall. Das ist der Alltag in einem Großteil der deutschen KMU.
Datensilos sind das unsichtbare Effizienzproblem im Mittelstand. Sie kosten Zeit, produzieren Fehler und sind – und das ist der eigentlich entscheidende Punkt – die größte Hürde für jede KI-Anwendung. Denn KI braucht Daten. Und Daten, die in 20 verschiedenen Tabellen verstreut sind, können nicht ausgewertet werden.
Das Excel-Problem: Warum Tabellen überall landen
Excel ist kein schlechtes Werkzeug. Es ist flexibel, überall verfügbar, leicht verständlich. Das Problem beginnt, wenn Excel zum Standard für alles wird.
In den meisten Mittelstandsunternehmen ist es so gewachsen: Abteilung A hat für ein spezifisches Problem eine Tabelle erstellt. Die Tabelle hat funktioniert. Irgendwann braucht Abteilung B ähnliche Informationen – also baut sie ihre eigene Version. Dann kommt eine neue Anforderung, eine neue Version entsteht. Nach einigen Jahren gibt es 20 oder 30 Tabellen, die sich teilweise überschneiden, teilweise widersprechen und alle manuell gepflegt werden müssen.
Das Symptom ist bekannt: Zwei Abteilungen nennen in einer Besprechung unterschiedliche Zahlen für denselben Sachverhalt. Beide haben recht – nur beziehen sie sich auf unterschiedliche Tabellen mit unterschiedlichen Datenständen.
Warum das mehr kostet als es scheint
Die direkten Kosten sind leicht zu berechnen: Wenn fünf Mitarbeiter täglich je eine Stunde damit verbringen, Daten manuell zu übertragen, zu aktualisieren und zu konsolidieren, sind das bei einem Stundensatz von 40 Euro bereits 200 Euro täglich – oder rund 50.000 Euro im Jahr. Für einen einzigen, wiederholbaren Prozess.
Die indirekten Kosten sind noch größer: falsche Entscheidungen auf Basis veralteter Daten, verpasste Chancen weil niemand schnell genug den Überblick hatte, Frustration bei Mitarbeitern, die wertvolle Zeit mit Copy-Paste verbringen statt mit inhaltlicher Arbeit.
Was ein Datensilo eigentlich ist – und warum er entsteht
Ein Datensilo ist eine Sammlung von Daten, die nur einer Abteilung oder Person zugänglich ist und nicht automatisch mit anderen Systemen synchronisiert wird.
Silos entstehen aus drei Gründen:
Fehlende Systemplanung beim Wachstum. Unternehmen wachsen schneller als ihre Dateninfrastruktur. Neue Abteilungen, neue Prozesse, neue Anforderungen – aber die IT-Infrastruktur hält nicht Schritt.
Abteilungsdenken. Jede Abteilung optimiert ihr eigenes System für ihre eigenen Bedürfnisse, ohne die Querverknüpfung zu beachten. Was für den Vertrieb praktisch ist, ist für das Controlling oft unbrauchbar.
Fehlende technische Vernetzung. Systeme, die nicht miteinander sprechen können, erzwingen manuelle Prozesse. Wenn das ERP keine Schnittstelle zum CRM hat, schreibt jemand die Kundendaten eben doppelt.
Technische Wege aus dem Datensilo
Die gute Nachricht: Das Problem ist lösbar. Und es muss nicht mit einem teuren, mehrjährigen IT-Projekt beginnen.
API-Anbindungen – die elegante Lösung
Eine API (Application Programming Interface) ist eine standardisierte Schnittstelle, über die zwei Systeme automatisch Daten austauschen können. Wenn dein CRM und dein ERP-System beide eine API haben, können sie so konfiguriert werden, dass Kundendaten automatisch synchronisiert werden.
Viele moderne Systeme – Salesforce, HubSpot, SAP, Microsoft Dynamics, Lexware – haben gut dokumentierte APIs. Die Einrichtung einer API-Anbindung ist in vielen Fällen eine einmalige technische Aufgabe, die wenige Stunden dauert.
Das Ergebnis: Wenn ein Vertriebsmitarbeiter im CRM einen Auftrag anlegt, erscheint er automatisch im ERP. Keine manuelle Übertragung, kein Fehler.
Middleware – der Übersetzer zwischen Systemen
Nicht alle Systeme sprechen dieselbe Sprache. Hier kommt Middleware ins Spiel – Software, die als Vermittler zwischen verschiedenen Anwendungen fungiert.
Tools wie Zapier, Make (früher Integromat) oder der Microsoft Power Automate ermöglichen es, Workflows zwischen unterschiedlichen Systemen zu definieren, ohne tiefes Programmierwissen. Das Prinzip: "Wenn in System A etwas passiert, mach in System B das."
Beispiel: Wenn ein Kunde eine E-Mail sendet und diese im Postfach landet, wird automatisch ein Ticket im Helpdesk-System erstellt, das CRM mit dem Kontakt verknüpft und der zuständige Mitarbeiter benachrichtigt. Was früher drei manuelle Schritte war, passiert automatisch in Sekunden.
ETL-Prozesse – für komplexere Integrationen
ETL steht für Extract, Transform, Load. Damit sind Prozesse gemeint, die Daten aus verschiedenen Quellen extrahieren, in ein einheitliches Format überführen und in ein zentrales System laden.
ETL ist relevant, wenn Datenquellen heterogen sind, Daten bereinigt oder transformiert werden müssen, oder wenn große Datenmengen aus Legacy-Systemen übertragen werden sollen.
Für mittelständische Unternehmen gibt es zugängliche ETL-Tools wie Talend, Airbyte oder Microsoft Azure Data Factory. Auch hier gilt: Der erste Schritt muss kein Großprojekt sein.
Zentrale Datenbanken und Data Warehouses
Langfristig ist die Einrichtung einer zentralen Datenbasis sinnvoll – ein sogenanntes Data Warehouse oder zumindest eine zentrale Datenbank, die als "Single Source of Truth" dient.
Der Unterschied zu einer weiteren Tabelle: Das Data Warehouse wird automatisch befüllt (durch die oben beschriebenen Integrationen), ist strukturiert und dokumentiert, und dient als verlässliche Grundlage für Auswertungen und Berichte.
Datenqualität: die unsichtbare Voraussetzung
Integration allein reicht nicht. Wenn Daten aus verschiedenen Systemen zusammengeführt werden, kommen auch deren Fehler zusammen. Doppelte Einträge, inkonsistente Schreibweisen, fehlende Pflichtfelder – das alles verringert den Wert der Daten.
Datenqualität ist kein einmaliges Projekt, sondern ein fortlaufender Prozess. Er beginnt mit einer ehrlichen Bestandsaufnahme: Welche Daten haben wir? Wie vollständig sind sie? Wie konsistent werden sie gepflegt?
Typische Probleme, die sich zeigen:
- Kundenname in drei verschiedenen Schreibweisen im System
- Umsatzdaten ohne klare Zuordnung zu Geschäftsjahr oder Produkt
- Fehlende Telefonnummern oder E-Mail-Adressen bei 40 Prozent der Kontakte
- Doppelte Datensätze durch manuelle Eingabe in mehreren Systemen
Diese Probleme müssen vor der KI-Einführung angegangen werden. Garbage in, garbage out – eine KI, die mit schlechten Daten trainiert oder betrieben wird, liefert schlechte Ergebnisse.
Warum Datenqualität die Grundlage für KI ist
Hier schließt sich der Kreis: Wer KI-Anwendungen im eigenen Unternehmen einführen will – sei es für Prognosen, Automatisierungen oder Analysen – braucht zuverlässige, zugängliche Daten.
Ein Lageroptimierungs-Algorithmus kann nicht arbeiten, wenn Bestandsdaten in drei verschiedenen Tabellen mit unterschiedlichen Aktualisierungsrhythmen liegen. Eine Kundenabwanderungs-Prognose ist wertlos, wenn die CRM-Daten unvollständig sind. Ein automatisierter Rechnungsprozess scheitert, wenn Kundennummern und Rechnungsadressen nicht konsistent gepflegt werden.
Die technische Readiness – also die Fähigkeit eines Unternehmens, KI produktiv einzusetzen – hängt zu einem wesentlichen Teil von der Datenqualität ab. Wer seine Datensilos aufbricht und seine Daten in Ordnung bringt, legt das Fundament für alle späteren KI-Initiativen.
Praktische Beispiele aus dem KMU-Alltag
Szenario 1: Der Maschinenbauer Ein mittelständischer Maschinenbauer hat Kundendaten im ERP, Servicedaten in einem separaten Ticketsystem und Vertriebsaktivitäten in einer Excel-Liste. Durch eine API-Anbindung zwischen ERP und Ticketsystem sowie die Migration der Vertriebsdaten in ein CRM entsteht eine 360-Grad-Sicht auf den Kunden. Ergebnis: Der Vertrieb sieht beim Kundengespräch sofort, welche Servicefälle gerade offen sind. Das vermeidet peinliche Missverständnisse und ermöglicht proaktive Kommunikation.
Szenario 2: Das Handelsunternehmen Ein Großhändler führt Bestelldaten in einem Legacy-System, Lieferantendaten in einer Access-Datenbank und Lagerdaten in einem separaten WMS. Über einen ETL-Prozess werden alle drei Quellen täglich in ein Data Warehouse konsolidiert. Ergebnis: Erstmals kann das Controlling in Echtzeit sehen, welche Produkte welche Marge erzielen – ohne stundenlangen manuellen Aufwand.
Szenario 3: Das Dienstleistungsunternehmen Ein Beratungsunternehmen pflegt Projektzeiten in einem Tool, Rechnungen in einem anderen und Kundenzufriedenheit in einem dritten. Über Middleware werden die drei Systeme verknüpft. Ergebnis: Projektrentabilität ist auf Knopfdruck abrufbar, Rechnungsstellung wird automatisch ausgelöst wenn ein Projekt als abgeschlossen markiert wird.
Fazit
Der Weg von der Tabelle zum System ist kein Mammutprojekt – er beginnt mit der Erkenntnis, dass das aktuelle Vorgehen echte Kosten hat. Ob API-Anbindung, Middleware oder ein schrittweiser Aufbau einer zentralen Datenbasis: Es gibt für jede Größe und jeden Reifegrad eine passende Lösung.
Wer heute seine Datensilos aufbricht, investiert nicht nur in Effizienz. Er legt das Fundament für alles, was danach kommt – datengetriebene Entscheidungen, Prozessautomatisierung und schließlich den produktiven Einsatz von KI.
"Datenqualität ist kein IT-Thema – es ist ein Führungsthema. Solange Daten in Abteilungssilos gefangen sind, kann kein Unternehmen das volle Potenzial seiner Informationen nutzen. Der erste Schritt ist immer: Klarheit darüber schaffen, was man überhaupt hat." – Marc Böhler, Gründer infinitask.ai